Calibração com Observações
Esta calibração ajusta os parâmetros do modelo à vazão, à profundidade da água, ao nível da água e à profundidade do lençol freático observados, todos ao mesmo tempo. Cada candidato é uma simulação completa do evento e recebe uma pontuação em cada série observada. Há dois métodos de busca. O padrão é um algoritmo genético (GA) que segue o GenericGA do MATLAB. O outro é o SCE-UA, a evolução de complexos embaralhados (shuffled complex evolution) da Universidade do Arizona. O usuário escolhe quais parâmetros ficam livres. Os outros mantêm os valores do modelo. No HydroPol2D Studio, essa calibração fica na área de trabalho Calibrate.
As duas ferramentas de calibração respondem a perguntas diferentes.
| Ferramenta | Dados | Ajusta |
|---|---|---|
| Esta página | Séries observadas de vazão, profundidade, nível da água e poços durante um evento ou período | Qualquer parâmetro do modelo, escolhido pelo usuário |
| Calibração por recessão das águas subterrâneas | Séries longas de vazões diárias, por meio da sua curva mestra de recessão | Condutividade e armazenamento do aquífero e o estado inicial das águas subterrâneas |
Os valores calibrados são parâmetros efetivos para esta estrutura de modelo e estes dados. Não são medições do solo nem do aquífero.
1. Observações
Cada série observada é um alvo. Um alvo tem um tipo, um local onde o modelo é comparado com ele e a sua própria pontuação.
| Tipo | Comparado com |
|---|---|
| Vazão | Um posto de roteamento ou o exutório do modelo (toda a vazão que sai pelos contornos) |
| Profundidade da água | Um posto de roteamento (a média das suas células), um ponto de observação ou a célula nas coordenadas da série |
| Nível da água (cota) | Como a profundidade da água, no mesmo datum do terreno |
| Profundidade do lençol freático | Um ponto de observação ou a célula nas coordenadas da série |
- Os tempos ficam em minutos a partir do início da simulação. A saída do modelo é interpolada para os tempos das observações.
- Um período de aquecimento é simulado, mas não é pontuado. As observações anteriores a ele são ignoradas.
- Changes only remove a média de cada série antes da pontuação. Serve para poços com datum incerto e para profundidades cuja cota do leito vem do DEM. Contam as subidas e as descidas, e um deslocamento constante não conta.
- A incerteza (opcional) é o erro de medição de cada valor, como um desvio padrão, nas unidades do valor. A Seção 2.3 explica como ela é usada.
As observações são registradas nos pontos de observação, que ainda não estão disponíveis nas malhas Voronoi e quadtree. Em uma malha, só a vazão nos postos de roteamento pode ser calibrada.
2. A Pontuação
2.1 Um erro por série
Cada série recebe um erro adimensional, que vale 0 para um ajuste perfeito. Assim, vazão, profundidades e níveis de poços podem ser somados. Na tabela, são os valores simulados e os observados.
| Pontuação | Erro | Padrão para |
|---|---|---|
| KGE | Vazão, profundidade da água, profundidade do lençol freático | |
| NSE | Nível da água | |
| NSE dos logaritmos | como o NSE, sobre ; favorece as vazões baixas | |
| RMSE / desvio padrão | ||
| Pico, volume e tempo do pico | a pontuação de hidrograma do GenericGA do HydroPol2D (abaixo) | |
| Erro / incerteza |
No KGE (Gupta et al., 2009), é a correlação, é a razão entre os desvios padrão e é a razão entre as médias, com . O NSE é a eficiência de Nash e Sutcliffe (1970), com . Níveis da água e cargas hidráulicas usam o NSE por padrão porque o seu datum é arbitrário, e a razão entre as médias do KGE diz pouco sobre um nível de 500 m. Com Changes only, o KGE deixa de lado o seu termo de viés.
A pontuação de pico, volume e tempo do pico é a pontuação composta do GenericGA do MATLAB
onde e são o pico observado e o seu tempo, e é o volume na janela pontuada.
2.2 Uma pontuação para a calibração
A calibração minimiza a média ponderada dos erros
onde percorre os eventos simulados e percorre as séries de cada evento. Sem pesos explícitos, cada tipo de observação recebe uma parcela igual, dividida igualmente entre as suas séries. Com um posto de vazão, um posto de profundidade e dois poços, os pesos são 1/3, 1/3, 1/6 e 1/6. Assim, dez poços não pesam mais que um posto de vazão. A profundidade e o nível da água contam como um só tipo, assim como a profundidade do lençol freático e a carga hidráulica. Quando o usuário dá um peso a qualquer série, as séries sem peso contam como 1 e todos os pesos são normalizados.
2.3 Uso da incerteza
Com Use uncertainty, cada ponto entra com o peso
de modo que os valores mais incertos pesam menos. As médias, as variâncias, a correlação e as somas de resíduos do KGE, do NSE, do NSE dos logaritmos e do RMSE / desvio padrão passam a usar esses pesos. Com a mesma incerteza em todos os pontos, as pontuações não mudam. Os valores sem incerteza recebem a mediana das incertezas conhecidas. A pontuação de pico, volume e tempo do pico ignora a incerteza.
A pontuação erro / incerteza usa a incerteza diretamente. Um valor de 1 significa que o modelo erra, em média, por um erro de medição. Abaixo de 1, o ajuste fica dentro do próprio erro dos dados. Os resultados também informam a fração dos pontos dentro de .
3. Parâmetros
Todos os parâmetros que o modelo pode calibrar aparecem na lista, e cada um é livre ou fixo. Os parâmetros fixos mantêm os valores do modelo. A lista acompanha os módulos ativos e o esquema de subsuperfície. Um caso sem neve não tem parâmetros de neve, e um caso em camadas não tem um rendimento específico único, porque nele vem da curva de retenção de cada camada.
Um parâmetro pode ser de três tipos.
| Tipo | Exemplo | O que muda |
|---|---|---|
| Um multiplicador sobre um campo do modelo | n de Manning × 1.3 | O valor da configuração, todas as linhas de classe e o raster, todos multiplicados, para que o mapa mantenha o seu padrão |
| Um valor de uma classe | n de Manning da cobertura do solo 2 | Aquela linha de classe |
| Um valor único | Multiplicador da condutividade lateral do regolito | Aquele valor da configuração |
Um multiplicador de campo dá exatamente o fator vezes o mapa preparado, qualquer que seja a entrada que forneceu cada célula. Comece por eles. Alguns poucos multiplicadores podem ser identificados onde muitos valores de classe não podem. Os limites ficam em escala logarítmica para condutividades, rugosidade e outros fatores positivos, e em escala linear para frações.
| Grupo | Parâmetros |
|---|---|
| Superfície | n de Manning, armazenamento em depressões, n de Manning do canal (canais de subgrade) |
| Solo e infiltração | Condutividade saturada, α e n de van Genuchten, θs, θr, profundidade do solo |
| Evapotranspiração e dossel | Profundidade radicular, coeficiente de cultura, cargas h3 e h4 de Feddes, armazenamento do dossel por LAI |
| Águas subterrâneas | Rendimento específico e condutividade das águas subterrâneas (esquema padrão), condutividade do leito do rio, carga capilar na capacidade de campo, anisotropia vertical |
| Subsuperfície em camadas | Multiplicadores da condutividade lateral do solo e do regolito, anisotropia lateral do solo, propriedades do regolito, profundidade da base do solo, profundidade até o leito rochoso |
| Aquífero profundo | Fração de recarga profunda, tempo de resposta, escoamento de base profundo inicial |
| Neve | Fator de graus-dia, limiares de temperatura de neve total e de chuva total, albedo, densidade da neve fresca |
| Qualidade da água | Máximo e taxa de acúmulo (buildup), coeficiente e expoente de lavagem (washoff), dias secos antecedentes |
| Estado inicial | Conteúdo inicial de água no solo, profundidade inicial do lençol freático |
Cada candidato passa pelas próprias regras de verificação do modelo antes de rodar. Um candidato com , ou com as cargas de Feddes fora de ordem, é recusado e recebe a pior pontuação.
4. A Busca
Os dois métodos trabalham com os parâmetros livres na sua escala de busca (logarítmica ou linear), partem do mesmo tipo de amostra e usam as mesmas pontuações, execuções em paralelo, execuções salvas e arquivos de resultados. A diferença está na forma de escolher os próximos candidatos.
4.1 SCE-UA
O SCE-UA (Duan et al., 1992; 1993) combina uma busca local por simplex com uma troca global de informação.
- Amostra inicial. pontos espalhados de modo uniforme entre os limites (um hipercubo latino), com o modelo atual como um deles, cada um pontuado com uma simulação completa do modelo.
- Distribuir em complexos. Os pontos são ordenados pela pontuação e distribuídos em complexos de pontos, como cartas de baralho, para que cada complexo tenha pontos bons e ruins.
- Evoluir cada complexo. Um complexo escolhe dos seus pontos, com preferência pelos melhores, e tenta substituir o pior deles. Primeiro, ele reflete o pior ponto em relação ao centroide dos outros. Se o ponto refletido não for melhor, ele faz uma contração até a metade do caminho em direção ao centroide. Se isso também falhar, ele sorteia um ponto na menor caixa que contém o complexo. Um complexo dá passos desse tipo.
- Embaralhar. Os complexos são reunidos, ordenados e distribuídos de novo, para que o que um complexo encontrou chegue aos outros.
- Repetir até que uma regra de parada seja atendida.
| Configuração | Padrão | Significado |
|---|---|---|
| Complexos | o número de parâmetros livres , no mínimo 2 | Mais complexos buscam de forma mais ampla e rodam mais modelos ao mesmo tempo |
| Pontos por complexo | ||
| Tamanho do simplex | Pontos que participam de um passo | |
| Passos de evolução | Passos de cada complexo entre embaralhamentos | |
| Máximo de execuções | 1000 | Verificado entre embaralhamentos |
| Parada por melhora | abaixo de 0.1 % em 5 embaralhamentos | |
| Parada por convergência | população mais estreita que 0.1 % da faixa | Média geométrica sobre os parâmetros livres |
| População inicial, limite de tempo, semente aleatória | como no GA |
Os padrões de , e são os recomendados por Duan et al. (1994). Entre um embaralhamento e outro, os complexos evoluem de forma independente, e por isso os seus passos rodam lado a lado. Com complexos, até execuções do modelo rodam ao mesmo tempo.
Em uma função de teste. O vale de Rosenbrock é um vale estreito e curvo, um caso clássico e difícil para otimizadores. A tabela abaixo usa as mesmas configurações acima, sem nenhum modelo envolvido.
| Parâmetros livres | SCE-UA | Algoritmo genético |
|---|---|---|
| 2 | ótimo encontrado (pontuação 1 × 10⁻⁷) em 375 execuções | pontuação 3 × 10⁻⁴ após 4 000 execuções |
| 6 | ótimo encontrado (pontuação 3 × 10⁻⁶) em 5 011 execuções | pontuação 3.6, longe do ótimo, após 12 000 execuções |
Na calibração de modelos chuva-vazão, o SCE-UA muitas vezes buscou de forma mais eficaz que um GA (uma comparação na Water, 2014). Ele nem sempre é melhor. Em um modelo distribuído, o SCE-UA e dois GAs deram resultados próximos (uma comparação na Hydrological Processes). A Seção 6.1 compara os dois na bacia gêmea.
4.2 Algoritmo genético
- População inicial. Espalhada de modo uniforme entre os limites (um hipercubo latino, McKay et al., 1979), com o modelo atual como um dos membros.
- Pontuar cada membro com uma simulação completa do modelo.
- Manter a elite. A melhor fração da população passa sem mudanças para a próxima geração.
- Escolher os pais por torneio. Cada pai é o melhor entre alguns membros sorteados.
- Cruzar. Um filho recebe uma mistura aleatória dos seus dois pais, parâmetro por parâmetro.
- Mutar. Alguns parâmetros recebem um passo gaussiano, truncado nos limites.
- Repetir até a última geração, uma parada antecipada ou o limite de tempo.
Um candidato já visto (um membro da elite ou uma duplicata) não é executado de novo.
| Configuração | Padrão | Significado |
|---|---|---|
| Tamanho da população | 10 por parâmetro livre, no mínimo 10 | Candidatos por geração |
| Gerações | 10 | Número máximo de gerações |
| Fração de elite | 20 % | Melhores membros copiados sem mudanças |
| Tamanho do torneio | 3 | Membros comparados para escolher um pai |
| Probabilidade de cruzamento | 85 % | Chance de um filho misturar dois pais |
| Probabilidade de mutação | 25 % | Chance de cada parâmetro sofrer mutação |
| Tamanho da mutação | 15 % da faixa | Desvio padrão de um passo de mutação |
| População inicial | Hipercubo latino, com o modelo atual | Ou aleatória uniforme |
| Parada antecipada | melhora abaixo de 1 % em 3 gerações | Pode ser desligada |
| Limite de tempo | nenhum | Verificado antes de cada geração |
| Semente aleatória | 42 | A mesma semente e as mesmas configurações repetem a mesma busca |
Os operadores e os seus valores padrão seguem o GenericGA do MATLAB, e assim os dois fazem buscas comparáveis.
4.3 Várias execuções ao mesmo tempo
| Modo | O que roda |
|---|---|
| One at a time | Cada execução usa o computador inteiro, com todas as threads da CPU ou com a GPU |
| Several at a time | O número escolhido de execuções, lado a lado, cada uma no seu próprio processo |
| Auto | Uma execução de teste mede a memória que usa. Depois, rodam ao mesmo tempo tantas execuções quantas couberem em 70 % da memória livre e na metade dos núcleos da CPU |
- Memória. Quando várias execuções precisariam de mais que a parcela permitida da memória livre, menos execuções rodam ao mesmo tempo, e o log informa isso.
- Threads. O limite de threads por execução vale para as bibliotecas numéricas e, no Linux, prende cada execução aos seus próprios núcleos. O JAX no macOS e no Windows escolhe o seu próprio número de threads.
- GPU. Em uma GPU, as execuções rodam uma de cada vez, a menos que cada execução receba uma parte da memória da GPU.
Em um notebook (10 núcleos, 24 GB), uma execução do caso gêmeo abaixo usou cerca de 0.74 GB e duas threads, e o Auto escolheu cinco execuções ao mesmo tempo.
4.4 Parada e retomada
Cada execução concluída é salva assim que termina. Cancel interrompe as execuções em andamento no próximo passo do modelo, e elas não são salvas. Uma calibração interrompida é retomada a partir da sua pasta. A busca repete a mesma semente a partir das execuções salvas e, assim, chega exatamente à população que uma busca sem interrupção teria. Na retomada, só podem mudar as configurações de parada. No GA, são o número de gerações, o limite de tempo e a parada antecipada. No SCE-UA, são o máximo de execuções, o limite de tempo e as regras de parada.
5. Resultados
5.1 Os dados conseguem determinar um parâmetro?
Para cada parâmetro livre, a calibração toma os melhores 10 % dos candidatos concluídos (no mínimo 5) e mede a dispersão entre eles, como fração da faixa de busca, na escala de busca.
| Dispersão | Veredito |
|---|---|
| até 0.25 | Determinado |
| 0.25 a 0.5 | Fracamente identificado |
| acima de 0.5 | Não identificado; os dados não permitem dizer, e é melhor fixá-lo |
A verificação precisa de pelo menos 30 execuções concluídas, ou de 10 por parâmetro livre, o que for maior. Antes disso, os melhores candidatos ficam próximos demais uns dos outros para uma conclusão.
5.2 Modelo atual e melhor execução
O modelo atual é o primeiro membro da primeira geração. Por isso, cada série aparece duas vezes, com os valores do próprio modelo e com os melhores valores. A comparação mostra o que a calibração mudou em cada série e se ela melhorou uma série à custa de outra.
5.3 Arquivos
| Arquivo | Conteúdo |
|---|---|
GA_Settings.json | Configurações, parâmetros livres e uma impressão digital das observações, verificada na retomada |
GA_Evaluations.jsonl | Cada execução concluída, salva assim que termina |
GA_History.csv | Cada candidato de cada geração, com parâmetros, pontuação e erro por série |
Best_Parameters.csv | O melhor valor de cada parâmetro livre, com os seus limites |
Best_Metrics.csv, Best_Series.csv | Erro, componentes da pontuação e valores observados e simulados, por série |
Comparison_Metrics.csv, Comparison_Series.csv | O mesmo para o modelo atual e a melhor execução, lado a lado |
Identifiability.csv | A dispersão e o veredito da Seção 5.1 |
GA_Performance.png | A pontuação de cada candidato e a melhor até o momento, por geração |
GA_Summary.json | Por que a busca parou, execuções, execuções ao mesmo tempo e tempo gasto |
Aplicar o resultado grava os melhores valores no modelo. Um multiplicador sobre um raster de entrada grava o raster escalado em calibrated_inputs, na pasta de resultados, e aponta o modelo para ele. O raster original não muda.
6. Experimento Gêmeo
Um experimento gêmeo testa o método antes do uso de dados reais. O modelo gera as "observações" a partir de valores conhecidos dos parâmetros, e a calibração precisa reencontrá-los.
| Configuração | Valor |
|---|---|
| Bacia | V-tilted, 50 × 81 células de 20 m, com duas encostas e um canal até o exutório |
| Processos | Infiltração, águas subterrâneas locais (esquema padrão), roteamento inercial local |
| Evento | 40 mm/h por 1.5 h, 3 h simuladas |
| Observações a cada 5 min | Vazão no exutório, profundidade da água em um ponto do canal, profundidade do lençol freático em uma encosta |
| Ruído | Gaussiano, 0 ou 5 % do desvio padrão de cada série |
| Parâmetros livres | Multiplicador do n de Manning (0.5 a 2), multiplicador da condutividade do solo (0.1 a 10) |
| Verdade | Manning × 1.4, condutividade × 0.5 |
| Configurações | Padrões: 20 por geração, 10 gerações, parada antecipada; Auto, 5 execuções ao mesmo tempo |
| Ruído | Manning encontrado | Condutividade encontrada | Execuções | Gerações | Tempo |
|---|---|---|---|---|---|
| 0 % | 1.401 | 0.497 | 100 | 7 (parada antecipada) | 4.2 min |
| 5 % | 1.410 | 0.502 | 140 | 10 | 5.1 min |
Os dois parâmetros foram recuperados com erro abaixo de 1 % e ficaram determinados nos dois níveis de ruído (rodada de 2026-10-28). O ruído é escalado pela variabilidade de cada série. Assim, o lençol freático, que se move milímetros neste evento, recebe um ruído de milímetros.
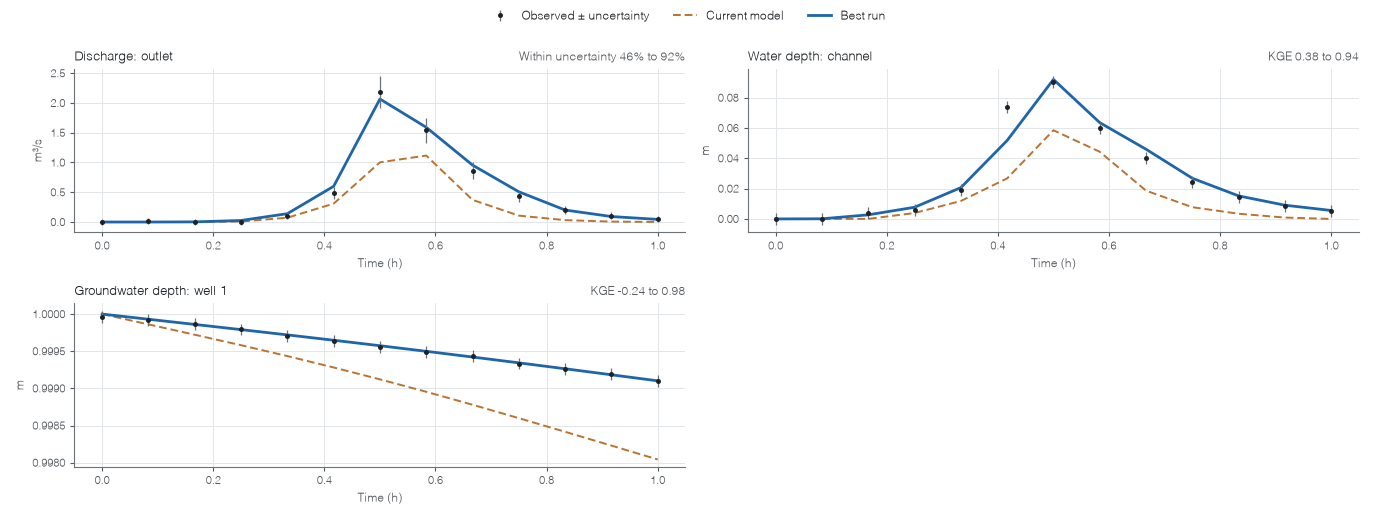
Figura 1. Uma calibração curta no Studio, na bacia do experimento gêmeo, com incerteza nas observações. A vazão é pontuada com erro / incerteza. Com o modelo atual, 46 % dos pontos ficavam dentro do seu erro de medição, e 92 % depois da calibração.
6.1 GA e SCE-UA
Na mesma bacia gêmea, com 5 % de ruído e um orçamento de cerca de 100 execuções por parâmetro livre (Auto, até 5 execuções ao mesmo tempo):
| Parâmetros livres | Método | Execuções | Melhor pontuação | Tempo | Encontrado / verdadeiro |
|---|---|---|---|---|---|
| 2 | GA | 140 | 0.0089 | 4.3 min | Manning 1.007, condutividade 1.004 |
| 2 | SCE-UA | 202 | 0.0074 | 9.3 min | Manning 1.021, condutividade 1.001 |
| 6 | GA | 481 | 0.0065 | 13.9 min | Manning 1.038, condutividade 0.998, rendimento específico 1.003 |
| 6 | SCE-UA | 659 | 0.0245 | 23.8 min | Manning 1.088, condutividade 0.949, rendimento específico 0.946 |
Com 6 parâmetros livres, os outros três eram o α do solo (verdadeiro × 1.3), a profundidade do solo (× 0.8) e a condutividade das águas subterrâneas (× 2). Nenhum dos métodos os determinou, porque estas observações dizem pouco sobre eles.
- Com 2 parâmetros, os dois métodos recuperaram a verdade. O SCE-UA chegou a uma pontuação um pouco melhor, mas seus 2 complexos permitem só 2 execuções ao mesmo tempo, e ele levou o dobro do tempo.
- Com 6 parâmetros e algumas centenas de execuções, o GA foi muito mais longe. O SCE-UA começa com 78 pontos e gasta de 78 a 234 execuções por embaralhamento, e o orçamento cobriu só cinco embaralhamentos.
- O SCE-UA compensa com orçamentos de milhares de execuções, como na função de teste da Seção 4.1. Para um modelo caro e algumas centenas de execuções, o GA é o padrão.
Um experimento gêmeo não é um teste de campo. Ele mostra que estas observações conseguem identificar estes parâmetros nesta estrutura de modelo. Séries reais acrescentam erro de medição, regularização das vazões e processos que o modelo deixa de fora.
7. Limites Atuais
- As observações pontuais (profundidades, níveis, poços) ainda não são registradas nas malhas Voronoi e quadtree.
- A umidade do solo ainda não pode ser calibrada. A sua tabela aparece, mas o modelo informa o armazenamento das camadas, e não o conteúdo de água.
- Os tempos são minutos a partir do início da simulação. Datas do calendário não são lidas.
- Mapas de extensão da inundação não são um tipo de alvo.
- O Studio calibra um evento. O motor de calibração também aceita vários eventos e eventos de validação, que rodam só para o melhor candidato.
- A pontuação é uma única soma ponderada. Uma frente de Pareto entre os tipos de observação não está disponível.
Fontes
- Duan, Q., Sorooshian, S., and Gupta, V. (1992). Effective and efficient global optimization for conceptual rainfall-runoff models. Water Resources Research, 28(4), 1015–1031. doi:10.1029/91WR02985
- Duan, Q. Y., Gupta, V. K., and Sorooshian, S. (1993). Shuffled complex evolution approach for effective and efficient global minimization. Journal of Optimization Theory and Applications, 76(3), 501–521. doi:10.1007/BF00939380
- Duan, Q., Sorooshian, S., and Gupta, V. K. (1994). Optimal use of the SCE-UA global optimization method for calibrating watershed models. Journal of Hydrology, 158(3–4), 265–284. doi:10.1016/0022-1694(94)90057-4
- Gupta, H. V., Kling, H., Yilmaz, K. K., and Martinez, G. F. (2009). Decomposition of the mean squared error and NSE performance criteria: implications for improving hydrological modelling. Journal of Hydrology, 377(1–2), 80–91. doi:10.1016/j.jhydrol.2009.08.003
- McKay, M. D., Beckman, R. J., and Conover, W. J. (1979). A comparison of three methods for selecting values of input variables in the analysis of output from a computer code. Technometrics, 21(2), 239–245. doi:10.2307/1268522
- Nash, J. E., and Sutcliffe, J. V. (1970). River flow forecasting through conceptual models, part I: a discussion of principles. Journal of Hydrology, 10(3), 282–290. doi:10.1016/0022-1694(70)90255-6