Calibración con Observaciones
Esta calibración ajusta los parámetros del modelo a varios tipos de observaciones a la vez. Estos tipos son el caudal, la profundidad del agua, el nivel del agua y la profundidad del agua subterránea. Cada candidato es una simulación completa del evento con el modelo, evaluada frente a todas las series observadas. Hay dos métodos de búsqueda. El predeterminado es un algoritmo genético (AG) que sigue el GenericGA de MATLAB. El otro es SCE-UA, la evolución de complejos barajados (shuffled complex evolution) de la Universidad de Arizona. El usuario elige qué parámetros son libres, y los demás conservan los valores del modelo. En HydroPol2D Studio, es el espacio de trabajo Calibrate.
Las dos herramientas de calibración responden a preguntas distintas.
| Herramienta | Datos | Ajusta |
|---|---|---|
| Esta página | Series observadas durante un evento o un período (caudal, profundidades, niveles del agua, pozos) | Cualquier parámetro del modelo, elegido por el usuario |
| Calibración por recesión del agua subterránea | Registros largos de caudal diario, a través de su curva maestra de recesión | Conductividad y almacenamiento del acuífero, y el estado inicial del agua subterránea |
Los valores calibrados son parámetros efectivos para esta estructura del modelo y estos datos. No son mediciones del suelo ni del acuífero.
1. Observaciones
Cada serie observada es un objetivo. Un objetivo tiene un tipo, un lugar donde se compara con el modelo y su propia puntuación.
| Tipo | Se compara con |
|---|---|
| Caudal | Una estación de enrutamiento, o la salida del modelo (todo el caudal que sale por los contornos) |
| Profundidad del agua | Una estación de enrutamiento (la media de sus celdas), un punto de observación o la celda en las coordenadas de la serie |
| Nivel del agua (cota) | Igual que la profundidad del agua, con el mismo nivel de referencia que el terreno |
| Profundidad del agua subterránea | Un punto de observación o la celda en las coordenadas de la serie |
- Los tiempos están en minutos desde el inicio de la simulación. La salida del modelo se interpola a los tiempos de observación.
- Un período de calentamiento se simula, pero no se evalúa. Las observaciones de ese período se ignoran.
- Changes only resta la media de cada serie antes de evaluarla. Está pensado para pozos cuyo nivel de referencia es incierto y para profundidades cuya cota del lecho proviene del DEM. Cuentan las subidas y bajadas, pero no un desplazamiento constante.
- La incertidumbre (opcional) es el error de medición de cada valor, expresado como una desviación estándar en las unidades del valor. La sección 2.3 explica cómo se usa.
Las observaciones se registran en puntos de observación, que todavía no están disponibles en mallas de Voronoi y quadtree. En esas mallas, solo se puede calibrar el caudal en las estaciones de enrutamiento.
2. La puntuación
2.1 Un error por serie
Cada serie recibe un error sin unidades, que vale 0 para un ajuste perfecto. Así, el caudal, las profundidades y los niveles en pozos se pueden sumar. En la tabla, son los valores simulados y los observados.
| Puntuación | Error | Predeterminada para |
|---|---|---|
| KGE | Caudal, profundidad del agua, profundidad del agua subterránea | |
| NSE | Nivel del agua | |
| NSE de valores logarítmicos | como NSE, sobre ; favorece los caudales bajos | |
| RMSE / desviación estándar | ||
| Pico, volumen y tiempo al pico | la puntuación de hidrograma del GenericGA de HydroPol2D (ver más abajo) | |
| Error / incertidumbre |
En KGE (Gupta et al., 2009), es la correlación, es la razón entre las desviaciones estándar y es la razón entre las medias. El error es . NSE es la eficiencia de Nash y Sutcliffe (1970), y . Los niveles del agua y las cargas hidráulicas usan NSE por defecto porque su nivel de referencia es arbitrario, y la razón entre medias de KGE dice poco sobre un nivel de 500 m. Con Changes only, KGE omite su término de sesgo.
La puntuación de pico, volumen y tiempo al pico es la puntuación compuesta del GenericGA de MATLAB.
Aquí, y son el pico observado y su tiempo, y es el volumen en la ventana evaluada.
2.2 Una puntuación para la calibración
La calibración minimiza la media ponderada de los errores.
Aquí, recorre los eventos simulados y las series de cada evento. Sin pesos explícitos, cada tipo de observación recibe una parte igual, repartida por igual entre sus series. Con una estación de caudal, una estación de profundidad y dos pozos, los pesos son 1/3, 1/3, 1/6 y 1/6. Así, diez pozos no pesan más que una estación de caudal. La profundidad y el nivel del agua cuentan como un solo tipo, y lo mismo ocurre con la profundidad del agua subterránea y la carga hidráulica. Cuando el usuario da un peso a alguna serie, las series sin peso cuentan como 1 y todos los pesos se normalizan.
2.3 Uso de la incertidumbre
Con Use uncertainty, cada punto cuenta con el peso
de modo que los valores más inciertos pesan menos. Las medias, las varianzas, la correlación y las sumas de residuos de KGE, NSE, NSE logarítmico y RMSE / desviación estándar usan entonces estos pesos. Si la incertidumbre es la misma en todos los puntos, las puntuaciones no cambian. Los valores sin incertidumbre toman la mediana de las incertidumbres conocidas. La puntuación de pico, volumen y tiempo al pico ignora la incertidumbre.
La puntuación error / incertidumbre la usa directamente. Un valor de 1 significa que el modelo se desvía, en promedio, en un error de medición. Por debajo de 1, el ajuste queda dentro del propio error de los datos. Los resultados también dan la fracción de puntos dentro de .
3. Parámetros
Se listan todos los parámetros que el modelo puede calibrar, y cada uno es libre o fijo. Los parámetros fijos conservan los valores del modelo. La lista sigue los módulos activos y el esquema de subsuelo. Un caso sin nieve no tiene parámetros de nieve, y un caso en capas no tiene un único rendimiento específico, porque allí proviene de la curva de retención de cada capa.
Un parámetro puede ser de tres tipos.
| Tipo | Ejemplo | Qué cambia |
|---|---|---|
| Un multiplicador sobre un campo del modelo | n de Manning × 1.3 | El valor de configuración, cada fila de clase y el ráster, todos multiplicados, de modo que el mapa conserva su patrón |
| Un valor de una clase | n de Manning de la cobertura del suelo 2 | Esa fila de clase |
| Un valor único | Multiplicador de la conductividad lateral del regolito | Ese valor de configuración |
Un multiplicador de campo da exactamente el factor por el mapa preparado, sea cual sea la entrada que aportó el valor de cada celda. Conviene empezar por ellos. Unos pocos multiplicadores se pueden identificar en casos en que muchos valores de clase no se pueden identificar. Los límites están en escala logarítmica para las conductividades, la rugosidad y otros factores positivos, y en escala lineal para las fracciones.
| Grupo | Parámetros |
|---|---|
| Superficie | n de Manning, almacenamiento en depresiones, n de Manning del canal (canales subgrid) |
| Suelo e infiltración | Conductividad saturada, α y n de van Genuchten, θs, θr, profundidad del suelo |
| Evapotranspiración y dosel | Profundidad de raíces, coeficiente de cultivo, cargas de Feddes h3 y h4, almacenamiento del dosel por unidad de LAI |
| Agua subterránea | Rendimiento específico y conductividad del agua subterránea (esquema predeterminado), conductividad del lecho del río, carga capilar de capacidad de campo, anisotropía vertical |
| Subsuelo en capas | Multiplicadores de la conductividad lateral del suelo y del regolito, anisotropía lateral del suelo, propiedades del regolito, profundidad de la base del suelo, profundidad hasta el lecho de roca |
| Acuífero profundo | Fracción de recarga profunda, tiempo de respuesta, flujo base profundo inicial |
| Nieve | Factor de grados-día, temperaturas de solo nieve y de solo lluvia, albedo, densidad de la nieve fresca |
| Calidad del agua | Máximo y tasa de acumulación (buildup), coeficiente y exponente de lavado (washoff), días secos antecedentes |
| Estado inicial | Contenido de agua inicial del suelo, profundidad inicial del nivel freático |
Cada candidato se verifica con las reglas propias del modelo antes de ejecutarse. Un candidato con , o con las cargas de Feddes fuera de orden, se rechaza y recibe la peor puntuación.
4. La búsqueda
Ambos métodos trabajan con los parámetros libres en su escala de búsqueda (logarítmica o lineal), parten del mismo tipo de muestra y comparten las puntuaciones, las simulaciones en paralelo, las simulaciones guardadas y los archivos de resultados. Se diferencian en la forma de elegir los siguientes candidatos.
4.1 SCE-UA
SCE-UA (Duan et al., 1992; 1993) combina una búsqueda local por símplex con un intercambio global de información.
- Muestra inicial. Se reparten puntos de forma uniforme entre los límites (un hipercubo latino), con el modelo actual como uno de ellos, y cada uno se evalúa con una simulación completa del modelo.
- Repartir en complejos. Los puntos se ordenan por puntuación y se reparten como cartas entre complejos de puntos, de modo que cada complejo tenga puntos buenos y malos.
- Hacer evolucionar cada complejo. Un complejo elige de sus puntos, con preferencia por los mejores, e intenta reemplazar el peor de ellos. Primero refleja el peor punto a través del centroide de los demás. Si el punto reflejado no es mejor, lo contrae hasta la mitad del camino hacia el centroide. Si eso también falla, toma un punto aleatorio en la caja más pequeña que contiene el complejo. Un complejo da pasos de este tipo.
- Barajar. Los complejos se juntan, se ordenan y se vuelven a repartir, de modo que lo que encontró un complejo llegue a los demás.
- Repetir hasta que se cumpla una regla de parada.
| Ajuste | Valor predeterminado | Significado |
|---|---|---|
| Complejos | el número de parámetros libres , al menos 2 | Con más complejos, la búsqueda es más amplia y se ejecutan más simulaciones a la vez |
| Puntos por complejo | ||
| Tamaño del símplex | Puntos que participan en un paso | |
| Pasos de evolución | Pasos de cada complejo entre dos barajados | |
| Máximo de simulaciones | 1000 | Se verifica entre barajados |
| Parada por mejora | mejora menor que 0.1 % en 5 barajados | |
| Parada por convergencia | población más estrecha que el 0.1 % del rango | Media geométrica sobre los parámetros libres |
| Población inicial, límite de tiempo, semilla aleatoria | como en el AG |
Los valores predeterminados de , y son los recomendados por Duan et al. (1994). Entre dos barajados, los complejos evolucionan de forma independiente, así que sus pasos se ejecutan en paralelo. Con complejos, se ejecutan hasta simulaciones del modelo a la vez.
En una función de prueba. El valle de Rosenbrock es un valle estrecho y curvo, un caso difícil clásico para los optimizadores. La tabla usa los mismos ajustes de arriba, sin ningún modelo de por medio.
| Parámetros libres | SCE-UA | Algoritmo genético |
|---|---|---|
| 2 | óptimo encontrado (puntuación 1 × 10⁻⁷) en 375 evaluaciones | puntuación 3 × 10⁻⁴ después de 4000 evaluaciones |
| 6 | óptimo encontrado (puntuación 3 × 10⁻⁶) en 5011 evaluaciones | puntuación 3.6, lejos del óptimo, después de 12 000 evaluaciones |
En calibraciones de modelos de escorrentía, SCE-UA ha buscado a menudo de forma más eficaz que un AG (una comparación en Water, 2014). No siempre es mejor. En un modelo distribuido, SCE-UA y dos AG dieron resultados parecidos (una comparación en Hydrological Processes). La sección 6.1 compara los dos en la cuenca gemela.
4.2 Algoritmo genético
- Población inicial. Se reparte de forma uniforme entre los límites (un hipercubo latino, McKay et al., 1979), con el modelo actual como uno de sus miembros.
- Evaluar cada miembro con una simulación completa del modelo.
- Conservar la élite. La mejor fracción se copia sin cambios a la siguiente generación.
- Elegir los padres por torneo. Cada padre es el mejor de unos pocos miembros elegidos al azar.
- Cruzar. Un hijo toma una mezcla aleatoria de sus dos padres, parámetro por parámetro.
- Mutar. Algunos parámetros reciben un paso gaussiano, recortado a los límites.
- Repetir hasta la última generación, una parada temprana o el límite de tiempo.
Un candidato ya visto (de la élite o duplicado) no se vuelve a ejecutar.
| Ajuste | Valor predeterminado | Significado |
|---|---|---|
| Tamaño de la población | 10 por parámetro libre, al menos 10 | Candidatos por generación |
| Generaciones | 10 | Número máximo de generaciones |
| Fracción de élite | 20 % | Mejores miembros copiados sin cambios |
| Tamaño del torneo | 3 | Miembros comparados para elegir un padre |
| Probabilidad de cruce | 85 % | Probabilidad de que un hijo mezcle dos padres |
| Probabilidad de mutación | 25 % | Probabilidad de que cada parámetro mute |
| Tamaño de la mutación | 15 % del rango | Desviación estándar de un paso de mutación |
| Población inicial | Hipercubo latino, con el modelo actual | O aleatoria uniforme |
| Parada temprana | mejora menor que 1 % en 3 generaciones | Se puede desactivar |
| Límite de tiempo | ninguno | Se verifica antes de cada generación |
| Semilla aleatoria | 42 | La misma semilla y los mismos ajustes repiten la misma búsqueda |
Los operadores y sus valores predeterminados siguen el GenericGA de MATLAB, por lo que ambos dan búsquedas comparables.
4.3 Varias simulaciones a la vez
| Modo | Qué se ejecuta |
|---|---|
| One at a time | Cada simulación usa todo el equipo (todos los hilos de la CPU, o la GPU) |
| Several at a time | El número elegido de simulaciones en paralelo, cada una en su propio proceso |
| Auto | Una simulación de prueba mide su memoria. Luego se ejecutan a la vez tantas simulaciones como caben en el 70 % de la memoria libre y en la mitad de los núcleos de la CPU |
- Memoria. Cuando varias simulaciones necesitarían más que la fracción permitida de la memoria libre, se ejecutan menos a la vez, y el registro lo indica.
- Hilos. El límite de hilos por simulación se aplica a las bibliotecas numéricas y, en Linux, fija cada simulación a sus propios núcleos. En macOS y Windows, JAX elige su propio número de hilos.
- GPU. En una GPU, las simulaciones se ejecutan de una en una, salvo que cada simulación reciba una parte de la memoria de la GPU.
En una computadora portátil (10 núcleos, 24 GB), una simulación del caso gemelo descrito más abajo usó cerca de 0.74 GB y dos hilos, y Auto eligió cinco simulaciones a la vez.
4.4 Detener y reanudar
Cada simulación terminada se guarda en cuanto termina. Cancel detiene las simulaciones en curso en su siguiente paso del modelo, y estas no se guardan. Una calibración detenida se reanuda desde su carpeta. La búsqueda repite la misma semilla a partir de las simulaciones guardadas, así que llega exactamente a la población a la que habría llegado una búsqueda sin interrupciones. Al reanudar, solo pueden cambiar los ajustes de parada. En el AG, son el número de generaciones, el límite de tiempo y la parada temprana. En SCE-UA, son el número máximo de simulaciones, el límite de tiempo y las reglas de parada.
5. Resultados
5.1 ¿Pueden los datos determinar un parámetro?
Para cada parámetro libre, la calibración toma el 10 % mejor de los candidatos terminados (al menos 5) y mide su dispersión. La dispersión se expresa como fracción del rango de búsqueda, en la escala de búsqueda.
| Dispersión | Veredicto |
|---|---|
| hasta 0.25 | Bien identificado |
| de 0.25 a 0.5 | Débilmente identificado |
| más de 0.5 | No identificado; los datos no lo distinguen y es mejor dejarlo fijo |
La verificación necesita al menos 30 simulaciones terminadas, o 10 por parámetro libre si ese número es mayor. Antes de eso, los mejores candidatos están demasiado próximos entre sí para sacar una conclusión.
5.2 Modelo actual y mejor simulación
El modelo actual es el primer miembro de la primera generación, por lo que cada serie se muestra dos veces, con los valores propios del modelo y con los mejores valores. La comparación muestra qué cambió la calibración en cada serie y si mejoró una serie a costa de otra.
5.3 Archivos
| Archivo | Contenido |
|---|---|
GA_Settings.json | Ajustes, parámetros libres y una huella de las observaciones, que se verifican al reanudar |
GA_Evaluations.jsonl | Cada simulación terminada, guardada en cuanto termina |
GA_History.csv | Cada candidato de cada generación, con sus parámetros, su puntuación y el error por serie |
Best_Parameters.csv | El mejor valor de cada parámetro libre, con sus límites |
Best_Metrics.csv, Best_Series.csv | Error, componentes de la puntuación y valores observados frente a simulados, por serie |
Comparison_Metrics.csv, Comparison_Series.csv | Lo mismo para el modelo actual y la mejor simulación, lado a lado |
Identifiability.csv | La dispersión y el veredicto de la sección 5.1 |
GA_Performance.png | La puntuación de cada candidato y la mejor hasta el momento, por generación |
GA_Summary.json | Por qué se detuvo la búsqueda, las simulaciones, las simulaciones a la vez y el tiempo empleado |
Aplicar el resultado escribe los mejores valores en el modelo. Un multiplicador sobre un ráster de entrada escribe el ráster escalado en calibrated_inputs, dentro de la carpeta de resultados, y hace que el modelo apunte a él. El ráster original no cambia.
6. Experimento gemelo
Un experimento gemelo pone a prueba el método antes de usar datos reales. El modelo genera las "observaciones" a partir de valores conocidos de los parámetros, y la calibración tiene que volver a encontrarlos.
| Configuración | Valor |
|---|---|
| Cuenca | En V, 50 × 81 celdas de 20 m; dos laderas y un canal hasta la salida |
| Procesos | Infiltración, agua subterránea local (esquema predeterminado), enrutamiento inercial local |
| Evento | 40 mm/h durante 1.5 h, 3 h simuladas |
| Observaciones cada 5 min | Caudal en la salida, profundidad del agua en un punto del canal, profundidad del agua subterránea en una ladera |
| Ruido | Gaussiano, 0 o 5 % de la desviación estándar de cada serie |
| Parámetros libres | Multiplicador de la n de Manning (0.5 a 2), multiplicador de la conductividad del suelo (0.1 a 10) |
| Verdad | Manning × 1.4, conductividad × 0.5 |
| Ajustes | Predeterminados (20 por generación, 10 generaciones, parada temprana); Auto, 5 simulaciones a la vez |
| Ruido | Manning encontrado | Conductividad encontrada | Simulaciones | Generaciones | Tiempo |
|---|---|---|---|---|---|
| 0 % | 1.401 | 0.497 | 100 | 7 (parada temprana) | 4.2 min |
| 5 % | 1.410 | 0.502 | 140 | 10 | 5.1 min |
Ambos parámetros se recuperaron con un error menor que 1 % y quedaron bien identificados en los dos niveles de ruido (simulación del 2026-10-28). El ruido se escala con la variabilidad propia de cada serie. Por eso el nivel freático, que se mueve unos milímetros en este evento, recibe un ruido de milímetros.
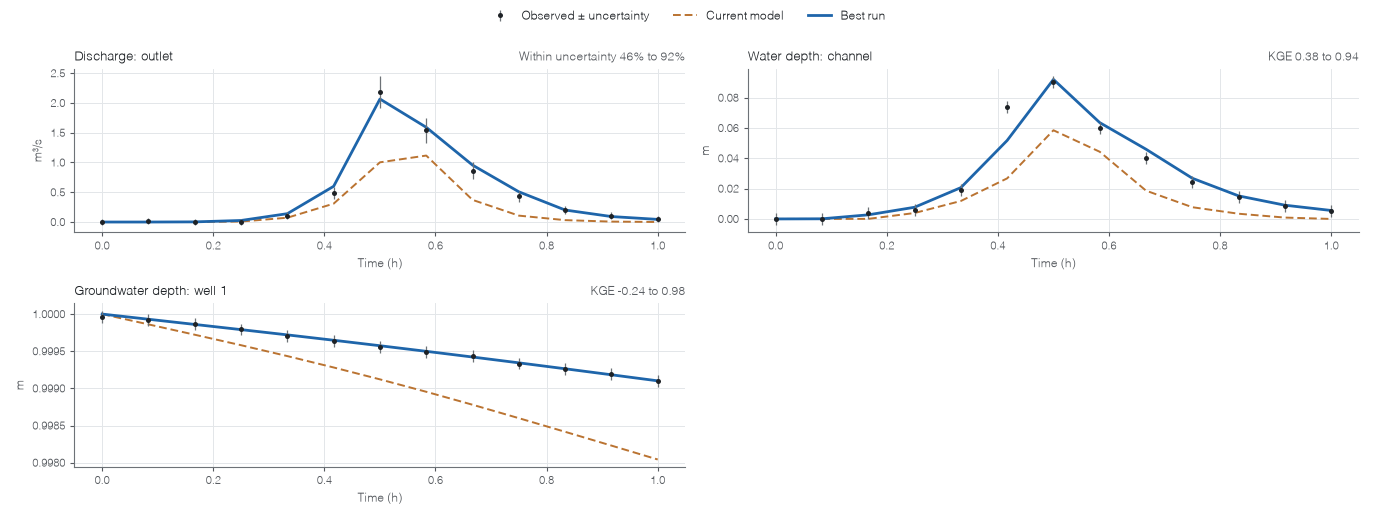
Figura 1. Una calibración corta en Studio sobre la cuenca gemela, con incertidumbre en las observaciones. El caudal se evalúa con error / incertidumbre. Con el modelo actual, el 46 % de los puntos estaba dentro de su error de medición, y el 92 % después de la calibración.
6.1 AG y SCE-UA
En la misma cuenca gemela, con un 5 % de ruido y un presupuesto de unas 100 simulaciones por parámetro libre (Auto, hasta 5 simulaciones a la vez):
| Parámetros libres | Método | Simulaciones | Mejor puntuación | Tiempo | Encontrado / verdadero |
|---|---|---|---|---|---|
| 2 | AG | 140 | 0.0089 | 4.3 min | Manning 1.007, conductividad 1.004 |
| 2 | SCE-UA | 202 | 0.0074 | 9.3 min | Manning 1.021, conductividad 1.001 |
| 6 | AG | 481 | 0.0065 | 13.9 min | Manning 1.038, conductividad 0.998, rendimiento específico 1.003 |
| 6 | SCE-UA | 659 | 0.0245 | 23.8 min | Manning 1.088, conductividad 0.949, rendimiento específico 0.946 |
Con 6 parámetros libres, los otros tres eran el α del suelo (verdadero × 1.3), la profundidad del suelo (× 0.8) y la conductividad del agua subterránea (× 2). Ningún método los identificó bien, porque estas observaciones dicen poco sobre ellos.
- Con 2 parámetros, los dos métodos recuperaron la verdad. SCE-UA llegó a una puntuación algo mejor, pero sus 2 complejos solo permiten 2 simulaciones a la vez, y tardó el doble.
- Con 6 parámetros y unos pocos cientos de simulaciones, el AG llegó mucho más lejos. SCE-UA empieza con 78 puntos y gasta de 78 a 234 simulaciones por barajado, y el presupuesto solo alcanzó para cinco barajados.
- SCE-UA compensa con presupuestos de miles de simulaciones, como en la función de prueba de la sección 4.1. Para un modelo costoso y unos pocos cientos de simulaciones, el AG es el predeterminado.
Un experimento gemelo no es una prueba de campo. Muestra que estas observaciones pueden identificar estos parámetros con esta estructura del modelo. Los registros reales añaden error de medición, regulación y procesos que el modelo no incluye.
7. Límites actuales
- Las observaciones puntuales (profundidades, niveles, pozos) todavía no se registran en mallas de Voronoi y quadtree.
- La humedad del suelo todavía no se puede calibrar. Su tabla se muestra, pero el modelo informa el almacenamiento de las capas, no el contenido de agua.
- Los tiempos son minutos desde el inicio de la simulación; no se leen fechas del calendario.
- Los mapas de extensión de la inundación no son un tipo de objetivo.
- Studio calibra un solo evento. El motor de calibración también acepta varios eventos y eventos de validación, que se ejecutan solo para el mejor candidato.
- La puntuación es una única suma ponderada; no hay un frente de Pareto entre tipos de observación.
Fuentes
- Duan, Q., Sorooshian, S., and Gupta, V. (1992). Effective and efficient global optimization for conceptual rainfall-runoff models. Water Resources Research, 28(4), 1015–1031. doi:10.1029/91WR02985
- Duan, Q. Y., Gupta, V. K., and Sorooshian, S. (1993). Shuffled complex evolution approach for effective and efficient global minimization. Journal of Optimization Theory and Applications, 76(3), 501–521. doi:10.1007/BF00939380
- Duan, Q., Sorooshian, S., and Gupta, V. K. (1994). Optimal use of the SCE-UA global optimization method for calibrating watershed models. Journal of Hydrology, 158(3–4), 265–284. doi:10.1016/0022-1694(94)90057-4
- Gupta, H. V., Kling, H., Yilmaz, K. K., and Martinez, G. F. (2009). Decomposition of the mean squared error and NSE performance criteria: implications for improving hydrological modelling. Journal of Hydrology, 377(1–2), 80–91. doi:10.1016/j.jhydrol.2009.08.003
- McKay, M. D., Beckman, R. J., and Conover, W. J. (1979). A comparison of three methods for selecting values of input variables in the analysis of output from a computer code. Technometrics, 21(2), 239–245. doi:10.2307/1268522
- Nash, J. E., and Sutcliffe, J. V. (1970). River flow forecasting through conceptual models, part I: a discussion of principles. Journal of Hydrology, 10(3), 282–290. doi:10.1016/0022-1694(70)90255-6